Warum Spaghetti-Diagramme Wartezeiten verstecken

Sponsored Post: Klassische Ansätze des Process Mining basieren auf Directly-Follows-Graphen. Diese Directly-Follows-Graphen zeigen, welche Aktivitäten in einem Prozess aufeinander folgen. Doch ihre Anordnung sagt meist erstaunlich wenig darüber aus, wie viel Zeit tatsächlich zwischen diesen Aktivitäten vergeht. Eine skalierte Zeitachse verändert den Blick auf Prozesse – und macht Wartezeiten sichtbar, die klassische Spaghetti-Diagramme optisch verstecken.
Process Mining verspricht einen objektiven Blick auf die Realität von Geschäftsprozessen. Statt einen Soll-Prozess zu modellieren, werden die tatsächlich aufgezeichneten Ereignisse aus ERP-, CRM-, Workflow- oder anderen Informationssystemen ausgewertet. Aus Event Logs entstehen Prozessmodelle, die zeigen, welche Aktivitäten ausgeführt wurden, in welcher Reihenfolge sie stattgefunden haben und welche Varianten eines Prozesses existieren. Eine der bekanntesten Darstellungsformen ist der Directly-Follows-Graph, kurz DFG. Er verbindet Aktivitäten miteinander, wenn die eine Aktivität in den aufgezeichneten Fällen unmittelbar auf die andere folgt. Bei einfachen Prozessen entstehen daraus anschauliche Modelle. Bei realen Geschäftsprozessen mit zahlreichen Varianten, Schleifen und Rücksprüngen entwickelt sich daraus jedoch schnell das bekannte Bild eines Spaghetti-Diagramms.
Das ist zunächst kein Fehler. Die Komplexität des Diagramms kann schließlich Ausdruck der tatsächlichen Komplexität des Prozesses sein. Klassische Directly-Follows-Graphen besitzen jedoch einen blinden Fleck: Sie zeigen die Reihenfolge der Zeit, aber nicht die Ausdehnung der Zeit. Zwei Aktivitäten, zwischen denen drei Sekunden liegen, können im Prozessmodell ebenso weit voneinander entfernt sein wie zwei Aktivitäten, zwischen denen drei Wochen verstreichen. Genau dadurch geht eine der wichtigsten Informationen des Prozessmanagements in der Visualisierung verloren.
Die Daten kennen die Zeit – die Visualisierung oft nicht
Das ist insofern bemerkenswert, weil Zeit im Process Mining keineswegs fehlt. Im Gegenteil: Event Logs basieren im Wesentlichen auf Zeitstempeln. Ohne sie ließe sich häufig nicht einmal rekonstruieren, in welcher Reihenfolge Aktivitäten ausgeführt wurden. Process-Mining-Systeme können Durchlaufzeiten berechnen, Wartezeiten analysieren und Performance-Kennzahlen auf einzelnen Prozesspfaden anzeigen. Die Zeit ist also vorhanden. Sie wird nur selten als grundlegendes visuelles Ordnungsprinzip des Prozessmodells verwendet.
Genau darauf weist auch die Forschung zum Timeline-based Process Discovery hin. Viele Process-Discovery-Verfahren nutzen Zeitstempel, um die zeitliche Ordnung von Ereignissen zu bestimmen, abstrahieren bei der Darstellung des resultierenden Prozessmodells jedoch weitgehend von der eigentlichen Zeitachse. Das klingt zunächst nach einem kleinen Visualisierungsproblem. Tatsächlich verändert es jedoch, wie wir Prozesse wahrnehmen.
Ein Zentimeter kann eine Sekunde oder eine Woche bedeuten
Menschen lesen Visualisierungen räumlich. Nähe suggeriert Zusammenhang, große Abstände suggerieren Distanz. Objekte, die auf einer Achse weit voneinander entfernt liegen, interpretieren wir intuitiv als entsprechend weit auseinanderliegend. Bei einem klassischen Directly-Follows-Graphen funktioniert diese Intuition für die Zeit jedoch nicht. Die Position einer Aktivität entsteht dort primär aus Anforderungen des Graph-Layouts: Verbindungen sollen dargestellt, Kreuzungen möglichst reduziert und Knoten auf einer begrenzten Fläche angeordnet werden.
Für die Darstellung der Prozessstruktur ist das sinnvoll. Der räumliche Abstand erhält dadurch jedoch keine klare zeitliche Bedeutung. Ein Zentimeter im Prozessmodell kann für fünf Sekunden, fünf Stunden oder fünf Tage stehen. Wer das Diagramm betrachtet, kann deshalb nicht aus dessen Geometrie ablesen, wo ein Prozess schnell voranschreitet und wo er wartet. Zeitinformationen müssen stattdessen über Kennzahlen, Beschriftungen oder zusätzliche Performance-Analysen gelesen werden. Der Unterschied ist subtil, aber wesentlich: Eine Zahl muss der Betrachter suchen und interpretieren. Eine Distanz erkennt er unmittelbar.
Das eigentliche Problem liegt häufig zwischen den Aktivitäten
Gerade für die Prozessoptimierung ist dieser Unterschied relevant. Denn die einzelnen Aktivitäten eines digitalen Geschäftsprozesses dauern häufig erstaunlich kurz. Ein Status wird gesetzt, ein Auftrag angelegt, eine Prüfung ausgelöst, eine Information übertragen, eine Freigabe gespeichert oder eine Rechnung gebucht. Viele dieser Vorgänge benötigen Sekunden oder Minuten. Die Durchlaufzeit eines Prozesses entsteht dagegen häufig an einer anderen Stelle: zwischen den Aktivitäten.
Dort wartet ein Vorgang auf eine Entscheidung, dort liegt eine Bestellung in einer Warteschlange, dort fehlt eine Information, dort wartet ein System auf eine manuelle Freigabe oder dort endet die Zuständigkeit einer Organisationseinheit und die nächste beginnt. Damit entsteht ein interessantes Missverhältnis: Ausgerechnet die Zeiträume, die für die Prozessperformance besonders relevant sein können, besitzen im klassischen Prozessmodell häufig keine entsprechende räumliche Präsenz.
„Ein Prozess besteht nicht nur aus Aktivitäten und ihrer Reihenfolge. Ein großer Teil seiner Realität liegt in der Zeit dazwischen. Wenn diese Zeit im Prozessmodell keinen Raum bekommt, bleibt auch ein Teil der Prozessperformance unsichtbar.“
Prof. Dr. Jan Mendling – Co-Founder Noreja
Spaghetti ist nicht automatisch langsam
Dieses Problem beeinflusst auch die Interpretation komplexer Process-Mining-Modelle. Ein dicht vernetzter Bereich eines Spaghetti-Diagramms zieht Aufmerksamkeit auf sich. Viele Linien, Schleifen und Varianten erzeugen visuelle Komplexität und damit schnell den Eindruck, dass genau dort das Problem liegen müsse. Das muss aber nicht stimmen. Ein Prozessbereich kann außerordentlich komplex aussehen und trotzdem innerhalb weniger Minuten abgewickelt werden. Umgekehrt kann eine einzige unscheinbare Verbindung zwischen zwei Aktivitäten für mehrere Tage Wartezeit stehen.
Damit sind zwei Eigenschaften zu unterscheiden: strukturelle Komplexität und zeitliche Ineffizienz. Ein Directly-Follows-Graph ist hervorragend darin, die erste sichtbar zu machen. Für die zweite benötigt er zusätzliche Informationen. Genau an diesem Punkt verändert eine Zeitachse die Perspektive.
Was passiert, wenn Zeit tatsächlich zu einer Achse wird?
Die Grundidee einer zeitbasierten Process-Mining-Visualisierung ist erstaunlich einfach: Die Position einer Aktivität wird nicht ausschließlich von einem Graph-Layout bestimmt, sondern zusätzlich von ihrem zeitlichen Auftreten im Prozess. Dafür können die Zeitstempel der einzelnen Prozessfälle zunächst relativ zum jeweiligen Prozessstart betrachtet werden. Der erste Event eines Falls liegt beispielsweise bei t = 0, eine Aktivität, die typischerweise zehn Minuten später stattfindet, entsprechend bei ungefähr t = 10 Minuten. Eine andere Aktivität tritt möglicherweise erst nach zwei Tagen auf.
Über viele Fälle hinweg lassen sich daraus typische relative Zeitpunkte der Aktivitäten bestimmen, beispielsweise über Mittelwerte oder andere geeignete Aggregationsmaße. Genau dieses Prinzip verfolgt der Forschungsansatz des Timeline-based Process Discovery: Die Aktivitäten eines Directly-Follows-Graphen werden entsprechend ihrer relativen zeitlichen Position im Prozess an einer Zeitachse ausgerichtet. Damit verändert sich die Semantik des Layouts. Abstand bekommt plötzlich Bedeutung.
Aus einem Graphen wird eine zeitliche Prozesslandschaft
Die Konsequenzen werden besonders deutlich, wenn viele Aktivitäten zeitlich dicht beieinanderliegen. Angenommen, ein Prozess beginnt mit acht verschiedenen Systemereignissen, Prüfungen und Statusänderungen. In einem klassischen Spaghetti-Diagramm können diese acht Aktivitäten einen erheblichen Teil der Visualisierung einnehmen. Die Zeitstempel zeigen jedoch möglicherweise, dass alle acht Ereignisse innerhalb von 90 Sekunden stattfinden. Danach passiert zwölf Stunden lang nichts, bevor die nächste Aktivität folgt.
Auf einer Zeitachse verändert sich das Bild fundamental. Die ersten acht Aktivitäten rücken zu einem kompakten Cluster zusammen, danach öffnet sich eine große Lücke. Die optisch dominante Information ist nun nicht mehr die Anzahl der Aktivitäten, sondern die verstrichene Zeit. Aus einem unübersichtlichen Prozessgraphen entsteht damit etwas, das man als zeitliche Prozesslandschaft verstehen kann. Man sieht Aktivitätscluster, zeitliche Phasen und lange Zwischenräume. Gerade diese Zwischenräume können für die Prozessverbesserung besonders interessant sein.
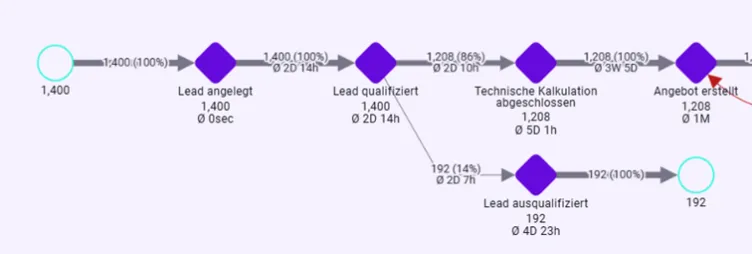
In Abbildung 1 ist eine Lead-To-Activation Prozessteil ohne Zeitskalierung dargestellt. Erkennbar ist, dass auf den ersten Blick keine großen zeitlichen Lücken erkennbar ist.
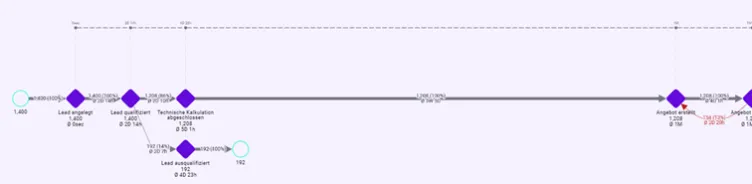
In Abbildung 2 hingegen wird nun die Zeitskalierung aktiviert und die große Lücke zwischen dem Schritt „Technische Kalkulation abgeschlossen“ und „Angebot erstellt“ wird sofort deutlich sichtbar.
Zeit erzeugt automatisch Prozessphasen
Noch interessanter als die reine chronologische Ordnung ist ein zweiter Effekt. Wenn Aktivitäten entsprechend ihres typischen zeitlichen Auftretens positioniert werden, entstehen häufig Gruppen von Aktivitäten, die ungefähr zur gleichen Zeit stattfinden. Diese temporalen Cluster können reale Prozessphasen sichtbar machen.
In der Untersuchung eines Vertriebsprozesses ließen sich beispielsweise zeitlich unterschiedliche Abschnitte erkennen: eine Lead-Erstellung in den ersten Sekunden, ein Lead-Setup in den ersten Stunden, eine Opportunity-Phase innerhalb der ersten Woche und eine Abschlussphase in den folgenden Wochen. Diese Phasen müssen nicht vorher modelliert werden. Sie entstehen aus den Zeitdaten. Das ist analytisch interessant, weil Prozessphasen damit nicht nur aus einer fachlichen Modellierungslogik abgeleitet werden, sondern aus dem tatsächlichen zeitlichen Verhalten des Prozesses. Zeit wird dadurch selbst zu einem Instrument der Strukturierung.
Die große Lücke ist oft interessanter als der große Knoten
Stellen wir uns einen Purchase-to-Pay-Prozess vor. Eine Bestellung wird angelegt. Nach zwei Minuten erfolgt eine automatische Prüfung, vier Minuten später wird eine Freigabe erfasst und eine weitere Minute später der Bestellstatus aktualisiert. Anschließend vergehen 31 Stunden bis zum nächsten relevanten Ereignis.
In einem klassischen DFG können diese vier Aktivitäten mit relativ gleichmäßigen Abständen erscheinen. Möglicherweise ist die Verbindung mit „31 h“ beschriftet. Analytisch ist die Information damit vorhanden, visuell konkurriert sie jedoch mit allen anderen Zahlen, Pfeilen, Knoten und Varianten. Auf einer skalierten Zeitachse passiert etwas anderes: Die ersten Aktivitäten verschmelzen nahezu zu einem Cluster, danach folgt eine große leere Strecke. Man muss die Zahl „31 Stunden“ nicht zuerst finden. Man sieht die 31 Stunden.
Damit verändert sich auch die erste analytische Frage. Statt zu fragen, warum ein Prozess so kompliziert ist, rückt die Frage in den Mittelpunkt, warum an einer bestimmten Stelle 31 Stunden lang nichts passiert. Für das Prozessmanagement ist das ein fundamentaler Perspektivwechsel.
Nicht nur Bottlenecks werden sichtbar
Eine Zeitachse bietet dabei mehr als die Identifikation einzelner Wartezeiten. Sie kann sichtbar machen, wann verschiedene Aktivitäten typischerweise parallel oder nahezu gleichzeitig auftreten, Unterschiede zwischen Prozessvarianten hervorheben oder zeigen, dass unterschiedliche Pfade strukturell verschieden aussehen, zeitlich aber nahezu identisch sind. Umgekehrt können zwei Varianten fast dieselben Aktivitäten enthalten, sich jedoch erheblich in ihrer Durchlaufzeit unterscheiden.
Auch temporale Ausreißer treten stärker hervor. In der wissenschaftlichen Evaluation wurde beispielsweise in einem Kreditprozess eine Aktivität sichtbar, die die Prozessdauer um ungefähr drei Monate verlängerte – ein Effekt, der im Standardlayout nicht in gleicher Weise als visueller Hinweis erkennbar war. Damit erweitert sich die klassische Frage des Process Mining. Nicht mehr nur „Welche Wege nehmen unsere Prozesse?“, sondern zusätzlich: Wie bewegen sich unsere Prozesse durch die Zeit?
Eine neue Sicht ersetzt die alte nicht
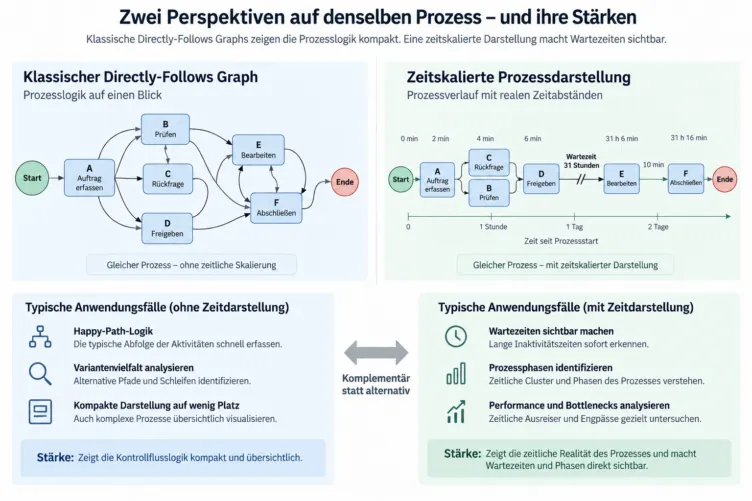
Dabei wäre es zu einfach, klassische Spaghetti-Diagramme grundsätzlich abzuschreiben. Sie besitzen einen erheblichen analytischen Wert. Wer Schleifen untersuchen, Prozessvarianten verstehen oder Abweichungen vom erwarteten Ablauf identifizieren möchte, benötigt die strukturelle Sicht auf den Prozess. Eine zeitbasierte Darstellung beantwortet andere Fragen. Es geht daher weniger um einen Ersatz als um einen Perspektivwechsel.
Man könnte von zwei komplementären Sichten sprechen. Die Control-Flow-Sicht beantwortet die Frage, was auf was folgt. Die Zeit-Sicht beantwortet, wann etwas passiert und wie viel Zeit zwischen den Aktivitäten liegt. Erst gemeinsam entsteht ein umfassenderes Bild.
Fazit: Wo verliert der Prozess seine Zeit?
Process Mining verfügt über Zeit. Es nutzt Zeitstempel zur Sortierung von Events, berechnet Durchlaufzeiten, identifiziert Verzögerungen und aggregiert Performance-Kennzahlen. Doch in vielen klassischen Prozessdarstellungen bleibt Zeit eine Zahl am Rand des eigentlichen Bildes.
Vielleicht sollten wir deshalb eine grundlegende Designentscheidung neu betrachten: Zeit muss nicht nur gemessen werden. Zeit kann dargestellt werden. Wenn zwei Aktivitäten fast gleichzeitig stattfinden, sollten sie auch fast gleichzeitig aussehen. Wenn zwischen zwei Prozessschritten mehrere Tage vergehen, darf diese Zeit im Modell Raum einnehmen. Und wenn zehn Aktivitäten innerhalb weniger Minuten passieren, während anschließend eine Woche lang nichts geschieht, sollte die Visualisierung nicht so tun, als seien beide Abschnitte gleich lang.
Vielleicht ist deshalb eine der interessantesten Fragen für die nächste Generation von Process-Mining-Visualisierungen nicht mehr nur: Was passiert in unserem Prozess? Sondern: Wo verliert unser Prozess eigentlich seine Zeit?

