Vom Quellsystem zum Prozessgraphen in Rekordzeit
Warum Noreja Daten schneller anbindet als klassisches Process Mining Tools
Sponsored Post
Ein Blick unter die Motorhaube von Noreja’s Ansatz der Datenanbindung – und warum der Verzicht auf klassische Event Logs den entscheidenden Unterschied macht.
Der teuerste Schritt im Process Mining ist der, den die Hochglanzfolien der Anbieter gerne verschweigen
Wer schon einmal ein Process-Mining-Projekt begleitet hat, kennt das Muster: Die Demo sieht beeindruckend aus, das Management ist begeistert – und dann beginnt die eigentliche Arbeit. Bevor auch nur ein einziges Prozessdiagramm entsteht, müssen die Rohdaten aus den Quellsystemen erst in ein passendes Format gebracht werden. Beim klassischen Ansatz heißt dieses Format: Event Log.
Ein Event Log ist eine flache Tabelle mit im Kern vier Attributen – einer Case ID, einer Aktivität, einem Zeitstempel und optionalen Kontextdaten. So elegant das klingt, so aufwendig ist der Weg dorthin. Die mehrdimensionale, vernetzte Realität einer Datenbank muss in eine zweidimensionale, einsträngige Struktur gepresst werden. Genau hier verlieren klassische Tools Zeit, Geld und – am schmerzhaftesten – Information.
In unserem ursprünglichen Whitepaper aus dem Jahr 2023 "The Causal Hypothesis" haben wir vorgerechnet, dass die initiale Erstellung eines Event Logs zwei bis drei Monate dauern und knapp 100.000 € an Berater- und internen Personalstunden verschlingen kann – und das pro Prozess. Allein der technische Aufbau des Event Logs nahm dabei typischerweise vier bis sechs Wochen in Anspruch. Das galt lange als unvermeidbarer Teil des Process Mining: Noch bevor die erste Prozessausführungen sichtbar wurden, mussten Rohdaten aus verschiedenen Tabellen extrahiert, die richtige Case ID identifiziert, Zeitstempel interpretiert, Datenquellen miteinander verknüpft und schließlich in eine analysierbare Struktur gebracht werden. Wochenlange Datenarbeit, bevor die eigentliche Analyse überhaupt beginnen konnte. Dieser Beitrag zeigt, wie wir diesen Schritt grundlegend anders angehen.
Warum das gerade für den Mittelstand den Unterschied macht
Diese Kosten treffen große Konzerne und den Mittelstand nicht gleich hart. Große Organisationen können sich eigene Data-Engineering- und Process-Mining-Teams leisten, die den Event-Log-Aufbau intern stemmen. Im Mittelstand ist das anders: Genau die entscheidenden Zwischenrollen – Data Engineers oder gar dedizierte Process-Mining-Expert:innen – existieren als Rollenprofil schlicht nicht. Wer trotzdem klassisches Process Mining einführen will, ist damit fast zwangsläufig auf externe Beratung angewiesen – und zwar nicht einmalig, sondern bei jeder Änderung erneut.
Ein Ansatz, der ohne diese Spezialrollen auskommt und die Datenanbindung radikal vereinfacht, ist deshalb für den Mittelstand kein „nice to have“, sondern die Voraussetzung dafür, Process Mining überhaupt wirtschaftlich nutzen zu können.
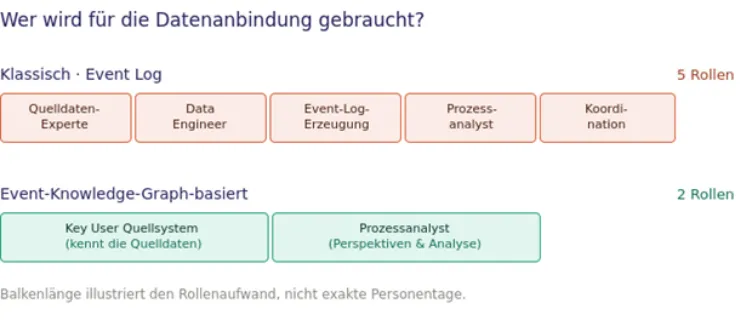
Abb. 1: Rollenaufwand bei der Datenanbindung – fünf Rollen im klassischen Event-Log-Ansatz gegenüber zwei Rollen im Event-Knowledge-Graph-basierten Ansatz.
Die Grundidee: Kein Event Log, sondern ein Event Knowledge Graph
Der fundamentale Unterschied zwischen Noreja und klassischen Anbietern lässt sich in einem Satz zusammenfassen:
„Sobald wir Zugriff auf die Rohdaten haben, stehen die ersten Modelle in 30 Minuten. Diese sind natürlich noch nicht vollständig oder perfekt, aber darauf aufbauend kann man iterativ und zielorientiert mit der Analyse weitermachen.“
— Dr. Lukas Pfahlsberger, Noreja Intelligence GmbH
Statt eines Event Logs bauen wir einen Event Knowledge Graph auf. Die Basis dafür ist ein sogenannter Entitätengraph: ein direktes, weitgehend verlustfreies Abbild der Quelldaten und ihrer Beziehungen. Dieser Graph ist anschließend die gemeinsame Ausgangsbasis für alle Analysen – nicht ein Wegwerfprodukt für genau einen Anwendungsfall.
Konkret bedeutet das: Die Nodes des Graphen sind die Datenobjekte in einer Aktivitätsform, die Relationships sind die semantischen Beziehungen zwischen diesen Nodes – zeitliche Beziehungen, kausale Beziehungen, weitere semantische Informationen und sogar Verknüpfungen mit unstrukturierten Kontextdaten. All das lässt sich im Graphen abbilden, ohne dass Information verloren geht. Wo das Event Log alles auf eine Zeile pro Ereignis reduziert, behält der Graph die volle Vernetzung.
Der Perspektivwechsel klingt technisch, hat aber massive praktische Konsequenzen für die Geschwindigkeit der Datenanbindung. Sehen wir uns an, wie das konkret abläuft.
Schritt 1: Datenobjekte 1:1 übernehmen – statt sie zu transformieren
Klassisches Process Mining beginnt mit einer Übersetzungsleistung. Und die ist alles andere als trivial. Im ersten Schritt müssen in den Datenobjekten die Aktivitäten korrekt abgegrenzt werden – häufig erst nach aufwendigen Datenbereinigungen. Man zieht sich die relevanten Werte aus Statusspalten heran, überführt sie aus ihrer Tabelle in einen flachen Event Log und muss sie dabei zusätzlich mit den Objekten anderer Tabellen in Beziehung setzen. In Summe braucht es dafür große ETL- und Datentransformationsstrecken, nur um die Daten überhaupt in das Event-Log-Format zu bekommen.
Die eigentliche Krux liegt aber in der fehlenden Flexibilität. Was passiert, wenn etwas vergessen wurde? Wenn sich eine Anforderung ändert? Wenn sich plötzlich die Case ID ändert? Dann muss der komplette Event Log umstrukturiert werden. Änderungen sind im klassischen Ansatz also nicht nur teuer, sondern strukturell kaum vorgesehen.
Wir drehen die Logik um. Noreja zieht die Datenobjekte aus der Quelle so heran, wie sie dort existieren – in der Regel als Datenbanktabellen oder als Antworten aus REST-API-Calls. Ein Objekt in der Quelle bleibt zunächst ein Objekt im Graphen. Es gibt keinen Zwang, an dieser Stelle bereits zu entscheiden, was ein „Ereignis“ ist und was nicht.
Das ist der erste große Zeitgewinn: Wir überspringen die aufwendige, fehleranfällige Vorab-Modellierung, bei der klassische Tools den Prozess bereits „kennen“ und die Daten fertig transformiert haben müssen, bevor überhaupt etwas angebunden ist.
Ein weiterer Vorteil dieses 1:1-Ansatzes: Es entsteht eine durchgängige Data Lineage. Jeder Datenpunkt in der Process-Mining-Analyse lässt sich eindeutig auf eine konkrete Datenbankzeile im Quellsystem zurückführen. Wo klassische ETL-Strecken die Herkunft eines Wertes über mehrere Transformationsschritte verwischen, bleibt bei uns jederzeit nachvollziehbar, woher jede einzelne Aktivität stammt – ein enormer Gewinn für Vertrauen, Audit und Fehlersuche.
Schritt 2: Schema-Informationen automatisch auslesen – die Kardinalitäten
Sobald die Datenobjekte bekannt sind, geht Noreja zurück in die Datenbank und liest die Schema-Informationen aus: Wie hängen diese Objekte eigentlich zusammen? Foreign Keys, Beziehungen, und vor allem die Kardinalitäten zwischen den Tabellen.
Diese Kardinalitäten sind Gold wert. Sie sagen uns, ob ein Auftrag zu genau einer Lieferung gehört oder zu mehreren, ob mehrere Rechnungen zu einer Zahlung gebündelt werden, ob ein Artikel Teil mehrerer Aufträge sein kann. Genau diese 1:n- und n:m-Beziehungen sind es, die klassische Event Logs beim „Flattening“ zerstören – und die dann als künstliche Self-Loops und Spaghetti-Diagramme wieder auftauchen.
Weil wir diese Beziehungen direkt aus dem Datenbankschema übernehmen, statt sie mühsam zu rekonstruieren, bekommen wir von Anfang an ein realitätsnahes Netzwerk statt eines verzerrten Abbilds.
Schritt 3: Zeitstempel per Heuristik erkennen – und daraus Aktivitäten ableiten
Jetzt kommt der Teil, der den Prozessaspekt ins Spiel bringt. Noreja durchsucht sämtliche angebundenen Tabellen nach Zeitstempel-Informationen und ordnet sie über einen heuristischen Ansatz automatisch ein:
- Erstellungs-Zeitstempel (wann wurde ein Objekt angelegt?)
- Änderungs-Zeitstempel (wann wurde es zuletzt modifiziert?)
- Fachliche Zeitstempel (z. B. Freigabedatum, Versanddatum, Zahlungseingang)
Aus diesen Zeitstempeln leiten wir innerhalb jedes einzelnen Objekts separate Prozessaktivitäten ab. Das Ergebnis ist ein sauberer 1-zu-n-Ansatz: Ein Datenobjekt aus der Quelle wird auf eine bis beliebig viele Prozessaktivitäten abgebildet – je nachdem, wie viele fachlich relevante Zeitpunkte es enthält.
Wie in Abbildung 2 zu sehen, schlägt Noreja auf Basis der Zeitstempel-Verteilung automatisch den passenden Start- und Änderungszeitstempel einer Tabelle vor – der Anwender muss den heuristischen Vorschlag nur noch bestätigen oder anpassen.
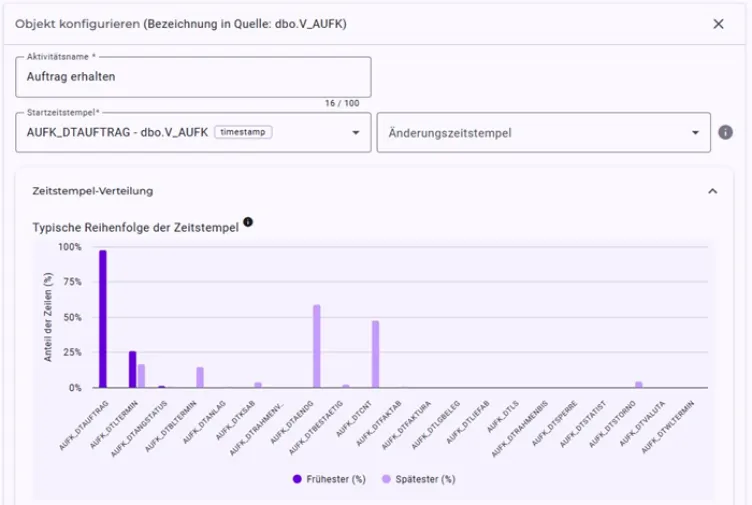
Abb. 2: Automatische Zeitstempel-Erkennung im Objekt-Konfigurator – die Verteilung „frühester/spätester Wert“ hilft, den fachlich richtigen Startzeitstempel zu wählen.
Dabei unterscheiden wir zwei Formen der Aktivitätsabgrenzung, die sich beliebig kombinieren lassen:
- Horizontal – entlang der Spalten: Für jede relevante Zeitstempel-Spalte einer Tabelle entsteht eine eigene Prozessaktivität. Eine Auftragstabelle mit den Spalten angelegt am, freigegeben am und versandt am liefert so direkt drei Aktivitäten.
- Vertikal – entlang der Werte einer Spalte: Wir nehmen eine bestimmte Spalte, die etwa einen Statuswert enthält, und erzeugen für jeden distincten Wert in dieser Spalte eine eigene Aktivität. Eine Statusspalte mit den Ausprägungen offen, in Bearbeitung und abgeschlossen wird so zu drei Aktivitäten.
Weil sich horizontal und vertikal kombinieren lassen, kann aus einer einzigen Tabelle eine ganze Reihe fein abgegrenzter Aktivitäten entstehen – ohne dass dafür separate Event-Log-Zeilen mühsam zusammengeführt werden müssten.
Wo klassische Tools also erst ein Event Log konstruieren müssen, in dem jede Zeile ein einzelnes Ereignis darstellt, entsteht bei uns die Aktivitätsstruktur direkt aus dem, was ohnehin in den Daten steht.
Schritt 4: Die Entitätenkonfiguration – Feinschliff ohne Neuaufbau
Der Entitätengraph ist bewusst offen gehalten und lässt sich über die Entitätenkonfiguration feinjustieren. Pro Entität kann festgelegt werden:
- Welcher Zeitstempel für die jeweilige Aktivität verwendet wird
- Welche Properties zusätzlich aus der Tabelle mitgeladen werden sollen (Beträge, Standorte, Kundenattribute, interne Klassifikatoren …)
- Welche zusätzlichen Einschränkungen gelten – etwa über ein ergänzendes SQL-Statement, um den Datenumfang gezielt einzugrenzen
- Welcher unstrukturierte Kontext ergänzt werden soll – etwa Dokumente wie SOPs, Arbeitsanweisungen oder Richtlinien, die sich direkt hochladen und mit der Entität verknüpfen lassen. So wandert nicht nur die strukturierte Datenrealität, sondern auch das prozessuale Fachwissen in den Graphen.
Und hier setzt ein weiterer Beschleuniger an: Diese Konfiguration muss nicht komplett manuell erfolgen. Ein KI-Agent kann die Konfiguration vorschlagen – von der Zuordnung der Zeitstempel bis zur Auswahl sinnvoller Properties. Der Fachanwender prüft und passt an, statt bei null zu beginnen. Abbildung 3 zeigt diesen Schritt: Noreja schlägt den Entity-Graph inklusive der relevanten Objekte und Beziehungen vor und baut daraus direkt die Prozessstruktur.
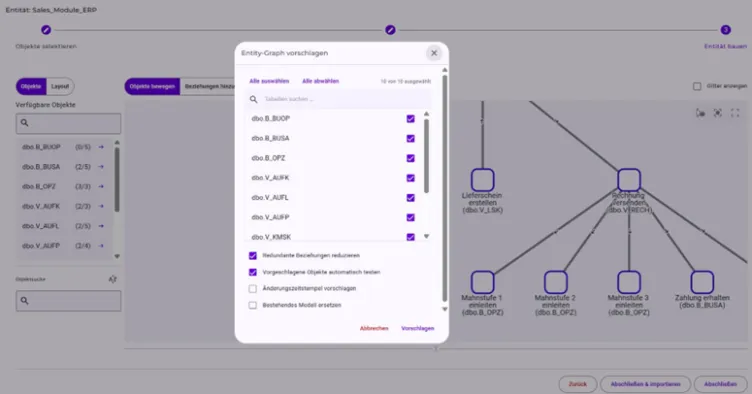
Abb. 3: KI-gestützter Vorschlag des Entity-Graphs – Objekte und Beziehungen werden automatisch ermittelt und lassen sich vor dem Bauen der Entität auswählen.
Der entscheidende Vorteil ist auch hier die Flexibilität. Wir können jederzeit iterativ neue Datenobjekte hinzufügen, bestehende löschen, bearbeiten oder im Label umbenennen. All das ist möglich, ohne einen komplett neuen Event Log oder eine neue Datenrepräsentation bauen zu müssen. Genau der Änderungsschmerz, der klassisches Process Mining so träge macht, entfällt.
Killer-Feature: der Macro-Prozessmodeler
Die flexible Graph-Architektur spielt ihre größte Stärke aus, wenn mehrere Quellsysteme zusammenkommen – etwa bei der Analyse eines systemübergreifenden Ende-zu-Ende-Prozesses. Der Ablauf ist denkbar einfach:
Schritt 1: Beide Systeme werden zunächst separat angebunden und jeweils in einem eigenen Entitätengraphen modelliert.
Schritt 2: Anschließend werden die noch getrennten Graphen über ein Objekt-Mapping verbunden – im Grunde ein JOIN auf Graph-Ebene. Das geschieht mit einem Klick: Die Verbindung wird direkt in den Graphen gezeichnet, und eine übergreifende Analyse ist sofort möglich.
Was in klassischen Ansätzen ein eigenes, aufwendiges Integrationsprojekt wäre – zwei getrennte Event Logs überhaupt erst kompatibel zu machen – wird hier zu einer Konfiguration auf bestehender Basis. Genau das meinen wir mit einem Macro-Prozessmodeler: die Fähigkeit, Prozesse über Systemgrenzen hinweg zu einem durchgängigen Gesamtbild zusammenzuführen.
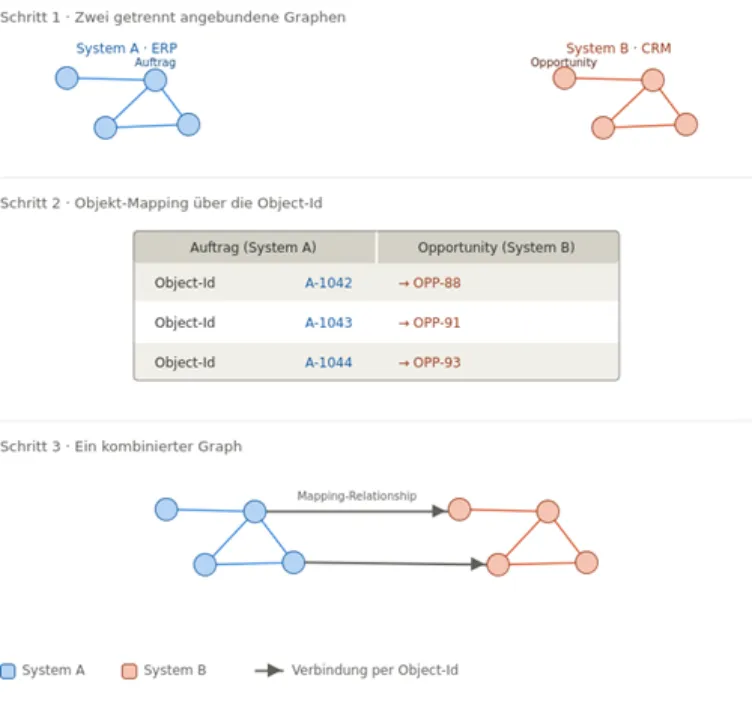
Abb. 4: Macro-Prozessmodeler in drei Schritten – getrennte Graphen, Objekt-Mapping über die Object-Id, kombinierter Graph mit neuen Mapping-Relationships.
Das Resultat: Wir kommen in kürzester Zeit von den Quelldaten zum fertigen Entitätengraphen – der dann die Grundlage für alles Weitere bildet.
Vom Datenmodell zur Analyse: Perspektiven statt Sackgassen
Der Entitätengraph ist im Grunde unser Datenmodell. Und auf dieses eine Datenmodell setzen wir beliebig viele Perspektiven des Prozesses auf. Hier verfolgen wir einen fundamental anderen Ansatz als klassische Tools: Eine Perspektive orientiert sich immer an einer konkreten Fragestellung.
Das heißt, für jede Businessfrage entsteht eine eigene Perspektive – mit einer konkreten Zielsetzung und einem konkreten Sollbild, das über die Hypothese definiert wird. So arbeitet man von Anfang an problembezogen: Man sieht direkt, wo die Realität von der eigenen Hypothese abweicht, wo die Abweichungen liegen, wo man genauer hineinschauen muss und wo tatsächlich Probleme sitzen.
Innerhalb einer Perspektive nutzen wir dafür die im Entitätengraphen konfigurierten Prozessaktivitäten, um eine Prozesshypothese zu bauen – den gewünschten oder erwarteten Ablauf. Diese Hypothese matchen wir anschließend gegen die tatsächlichen Daten. Der Clou: Weil wir sowohl den Soll-Ablauf (die Hypothese) als auch den Ist-Ablauf (die Daten) kennen, fallen Abweichungen direkt und automatisch heraus – ganz ohne nachgelagerte Conformance-Checking-Zusatzschritte. In Abbildung 5 sind solche Abweichungen als rote Pfade direkt in der Perspektive sichtbar, die vom erwarteten Ablauf abzweigen.
Auch das Anlegen der Perspektiven muss nicht bei null beginnen: Sie lassen sich von der KI vorschlagen. Dafür bringen wir die im Entitätengraphen vorhandenen Datenobjekte mithilfe von KI in eine logisch-kausale Reihenfolge – wir fragen die KI also gewissermaßen: „Wie könnten oder sollten diese Prozessaktivitäten in einem typischen Soll-Ablauf hintereinander stehen?“ Auf dieser Basis kann die KI die Abgrenzung sinnvoller Perspektiven zurechtschneiden und konkrete Vorschläge machen, die der Anwender dann nur noch prüfen und schärfen muss.
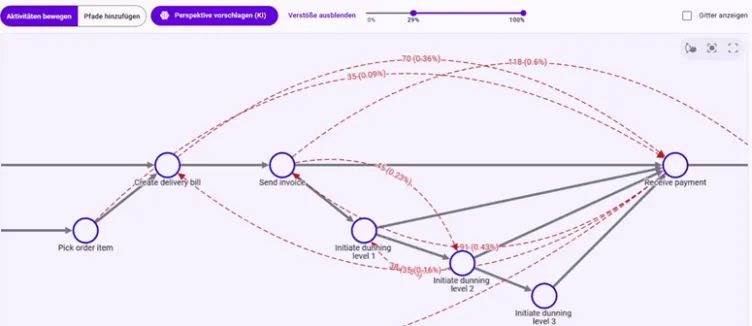
Abb. 5: KI-vorgeschlagene Perspektive mit Soll-Ablauf (graue Pfade) und automatisch erkannten Verstößen (rote Pfade); über den Regler lässt sich die Verstoß-Schwelle einstellen.
Zwei weitere Eigenschaften machen die Perspektiven besonders mächtig:
- Case ID per Mausklick wechseln. Der Datenscope einer Perspektive lässt sich mit einem einzigen Klick ändern. Genau genommen handelt es sich dabei nicht um eine reine Case ID, sondern um eine Mischung aus Object ID und Case ID: Wir definieren die ID auf einem Datenobjekt – und erst in dem Moment, in dem wir sie innerhalb einer Perspektive verwenden, wird sie zur Case ID. Denselben Prozess einmal aus Sicht der Auftragsnummer, einmal aus Sicht des Standorts, einmal aus Sicht des Mitarbeiters zu betrachten, ist damit Sekundensache – und erfordert keine neue Datenanbindung.
- Beliebig viele Perspektiven, frei kombinierbar. Perspektiven lassen sich beliebig oft anlegen und theoretisch auch miteinander kombinieren. Jede weitere Perspektive baut auf demselben Entitätengraphen auf und verursacht nur noch einen Bruchteil des ursprünglichen Aufwands.
Beim klassischen Ansatz würde jede dieser Sichtweisen ein eigenes, neu extrahiertes Event Log erfordern. Bei uns ist es eine Konfiguration auf bestehender Basis.
Was das gegenüber klassischen Tool-Anbietern bedeutet
Der Markt für Process Mining wird im Grunde von zwei bis vier klassischen Anbietern geprägt, die ca. 85% des Marktes auf sich vereinen. Sie haben ihre Werkzeuge über Jahre um den Event Log (später dann den Object-Centric Event Log) als zentrale Eingabestruktur herum gebaut – mit vorgefertigten Konnektoren für Standardsysteme wie SAP, Salesforce, ServiceNow oder Oracle.
Diese Standardkonnektoren beschleunigen die Anbindung – aber nur, solange man ein Standardsystem in weitgehend unangepasster Form betreibt. In der Praxis steigt der Individualisierungsgrad von ERP-Systemen über die Zeit an, und regionale Softwarelösungen im Mittelstand haben oft gar keinen fertigen Konnektor. Sobald das der Fall ist, greift wieder der teure, langwierige ETL- und Event-Log-Zyklus. Der Noreja-Ansatz unterscheidet sich fundamental:
| Klassisches Process Mining | Noreja | |
|---|---|---|
| Datenstruktur | Flaches Event Log (2D bzw. 3D bei OCEL) | Event Knowledge Graph (vernetzt) |
| Anbindung | Transformation & ETL vorab nötig | Datenobjekte 1:1 aus der Quelle |
| Beziehungen | Beim Flattening verloren | Kardinalitäten direkt aus dem Schema |
| Aktivitäten | Aufwendig selektiert | Heuristisch aus Zeitstempeln abgeleitet |
| Konfiguration | Spezialisten & Beraterzyklen | KI-gestützte Vorschläge, im Tool anpassbar |
| Neue Sichtweise | Neues Event Log extrahieren | Object-/Case-ID per Klick wechseln |
| Wiederverwendbarkeit | Ein Log = ein Use Case | Ein Graph = beliebig viele Perspektiven |
Warum Geschwindigkeit hier mehr ist als ein nettes Extra
Man könnte einwenden: „Ein paar Monate Einrichtung – das amortisiert sich doch über die Projektlaufzeit.“ Das stimmt nur, solange sich nichts ändert. Und in der Realität ändert sich ständig etwas.
Genau das ist der Punkt. Je teurer und langsamer eine Iteration ist, desto seltener iteriert man – und desto eher bleibt man beim Status quo, statt den Prozess wirklich zu verbessern. Ein schneller, graphbasierter Anbindungsprozess dreht diese Dynamik um: Änderungen an der Konfiguration, neue Perspektiven, neue Fragen an die Daten kosten nur noch einen Bruchteil. Process Mining wird damit von einem einmaligen Großprojekt zu einem laufenden, explorativen Werkzeug.
Und weil der Entitätengraph ein vollwertiges, wiederverwendbares Datenmodell ist, endet sein Nutzen nicht beim Prozessdiagramm. Er wird zur zentralen Basis für weitergehende Analysen – bis hin zu einem digitalen Zwilling der Organisation.
Fazit
Der Geschwindigkeitsvorteil von Noreja bei der Datenanbindung ist kein Zufall und kein reiner Performance-Trick. Er ist die direkte Folge einer grundlegend anderen Architektur:
- Wir übernehmen Datenobjekte 1:1 aus der Quelle, statt sie vorab zu transformieren.
- Wir lesen Kardinalitäten direkt aus dem Datenbankschema und bewahren so die vernetzte Realität.
- Wir leiten Prozessaktivitäten heuristisch aus Zeitstempeln ab, statt Event Logs manuell zu konstruieren.
- Wir lassen die Konfiguration KI-gestützt vorschlagen und im Tool feinjustieren.
- Und wir setzen beliebig viele, per Klick umschaltbare Perspektiven auf denselben Graphen auf.
Das Ergebnis: In kürzester Zeit von der Quelle zum analysebereiten Prozessgraphen – und von dort aus so oft und so tief in die Prozesse, wie es das Unternehmen braucht.
Und noch ein Punkt wird gerade jetzt immer wichtiger: Ein Knowledge Graph ist als Datenstruktur weitaus besser für den Einsatz von KI geeignet als ein Event Log. Der Graph lässt sich später intelligent von KI und LLMs durchsuchen; Relationships, die für eine konkrete Anfrage nicht relevant sind, können dabei einfach ignoriert werden. Ein Event Log ist demgegenüber eine starre Struktur, die genau einem Zweck folgt – und darüber hinaus wenig hergibt. Wer heute die Datenbasis für die KI-Anwendungen von morgen legt, legt sie besser als Graph.
Neugierig, wie schnell Ihre eigenen Systeme angebunden wären? Sprechen Sie mit uns.

