Purchase to Pay: Wenn der schnellste Prozess der falsche ist

Sponsored Post - Wie Causal Process Mining Freigabeumgehungen, Nacharbeit und verborgene Prozesskosten im Purchase-to-Pay sichtbar macht
Purchase-to-Pay wirkt auf den ersten Blick wie ein gut strukturierter Standardprozess: Eine Bestellanforderung wird erstellt, geprüft und freigegeben. Es folgt die Bestellung, die Ware oder Leistung geht ein, die Rechnung wird geprüft und schließlich bezahlt. In der operativen Realität eines Sondermaschinenbauers ist dieser Ablauf deutlich komplexer. Eine Bestellung kann mehrere Positionen umfassen. Physische Materialien und Software folgen unterschiedlichen Beschaffungswegen. Rechnungen beziehen sich auf Bestellungen, Wareneingänge und Konditionen. Prüfplätze werden von vielen Vorgängen gleichzeitig genutzt. Und eine kurze Durchlaufzeit ist nicht automatisch ein Qualitätsmerkmal – etwa dann, wenn dafür notwendige Freigaben umgangen werden. Das folgende Praxisbeispiel zeigt anhand eines synthetischen P2P-Datensatzes, wie Noreja solche Zusammenhänge mit granular übernommenen Daten, einem Event Knowledge Graph, Causal Process Mining und zusätzlichem fachlichem Kontext untersucht. Die Kennzahlen dienen ausschließlich zur Demonstration der Analysewege und sind keine Produktivkennzahlen eines Kunden.
Warum Purchase-to-Pay nicht auf eine lineare Prozesskette passt
Die erste Herausforderung liegt bereits in der Datenstruktur. Ein Purchase-to-Pay-Prozess besteht nicht aus einem einzigen Geschäftsobjekt. Bestellanforderung, Freigaben, Bestellung, Bestellposition, Lieferant, Material, Lieferung, Wareneingang, Prüfung, Rechnung und Zahlung besitzen jeweils eigene Attribute und Beziehungen. Noreja übernimmt diese Daten granular und erhält die Beziehungen zwischen den Geschäftsobjekten. Die Prozessrealität wird damit nicht bereits vor der Analyse auf eine einzelne Case-ID oder eine lineare Sicht reduziert. Erst für eine konkrete fachliche Fragestellung wird entschieden, welcher Ausschnitt relevant ist. Das wird im P2P-Prozess besonders deutlich: Nach der Bestellposition können physische Materialien über Lieferung, Warenannahme und Wareneingangsprüfung laufen, während Software über eine Bereitstellung geführt wird. Später treffen die Wege wieder in der Rechnungsbearbeitung zusammen.
Komplexität wird für die Analyse reduziert – nicht in den zugrunde liegenden Daten.
Dieser Ansatz schafft die Voraussetzung dafür, später zwischen unterschiedlichen Ursache-Wirkungs-Zusammenhängen zu unterscheiden: Freigabeumgehung, operative Kapazität, Rechnungsnacharbeit oder Lieferantenperformance brauchen jeweils eine andere fachliche Perspektive.
Aus granularen Daten wird eine steuerbare End-to-End-Perspektive
Für den Prozessverantwortlichen muss die Analyse trotz dieser Granularität verständlich bleiben. Deshalb wird aus dem gemeinsamen Prozesswissen eine End-to-End-Perspektive erzeugt, die den relevanten Weg von der Bestellanforderung bis zur Zahlung zusammenführt.
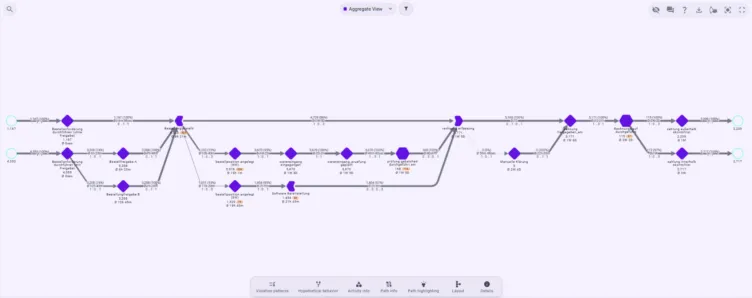
Die Perspektive zeigt bereits mehrere fachlich unterschiedliche Wege. Bestellanforderungen können je nach Situation unterschiedliche Freigabelogiken durchlaufen. Physische und digitale Beschaffung verzweigen. Und am Prozessende wird sichtbar, ob eine Zahlung innerhalb oder außerhalb der Skontofrist liegt. Damit verändert sich die typische Prozessfrage. Statt nur zu fragen, wie lange der gesamte Purchase-to-Pay-Prozess dauert, lässt sich untersuchen:
Welche Prozessbedingungen führen dazu, dass ein gewünschtes Ergebnis erreicht – oder verfehlt – wird?
Genau an dieser Stelle beginnt Causal Process Mining: Nicht nur das beobachtete Verhalten wird sichtbar, sondern auch die fachlichen Abhängigkeiten und Bedingungen, gegen die dieses Verhalten interpretiert werden kann.
Wenn viele Vorgänge dieselbe Ressource teilen
Ein gutes Beispiel liefert die Wareneingangsprüfung. Physische Bestellpositionen müssen nach dem Wareneingang geprüft werden. Diese Prüfung findet jedoch nicht isoliert innerhalb eines einzelnen Vorgangs statt. Viele Wareneingänge teilen sich dieselben Prüfressourcen und werden in gemeinsamen Prüfläufen verarbeitet.
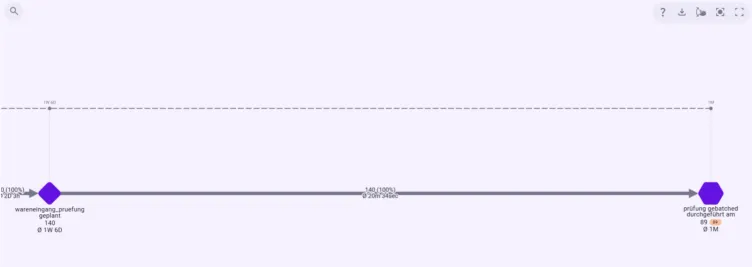
Damit entsteht eine Cross-Case-Abhängigkeit: Ein einzelner Vorgang kann fachlich vollständig korrekt sein und trotzdem warten, weil andere Wareneingänge dieselbe Ressource beanspruchen. Der Batch ist dabei ein eigenes Geschäftsobjekt, das mehrere Prüfungen miteinander verbindet. In der Zeitperspektive wird diese Logik besonders anschaulich. Die geplanten Prüfungen verteilen sich über die Zeit, während die tatsächlich gebündelt durchgeführten Prüfungen in wiederkehrenden Clustern auftreten.
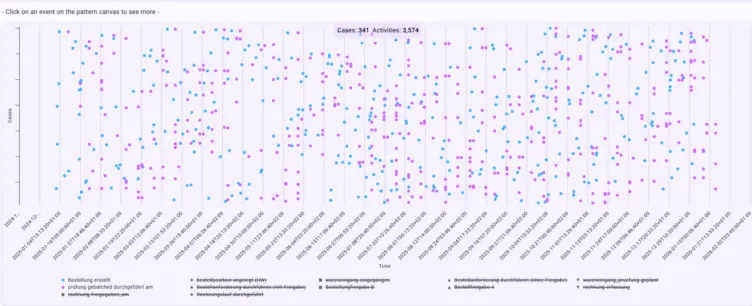
Die Analysefrage lautet damit nicht mehr nur: „Welche Aktivität dauert lange?“ Sondern:
„Entsteht die Wartezeit im einzelnen Vorgang – oder durch eine gemeinsam genutzte Kapazität außerhalb seiner eigenen Prozesshistorie?“
Das ist ein wesentlicher Unterschied. Denn aus beiden Situationen würden völlig andere Verbesserungsmaßnahmen folgen.
Vom sichtbaren Engpass zur wirtschaftlichen Wirkung
Im nächsten Schritt lassen sich genau diejenigen Prüfungen isolieren, bei denen die verfügbare Kapazität tatsächlich überschritten wurde. Im aktuellen synthetischen Demo-Run sind 92 Prüfungen betroffen.
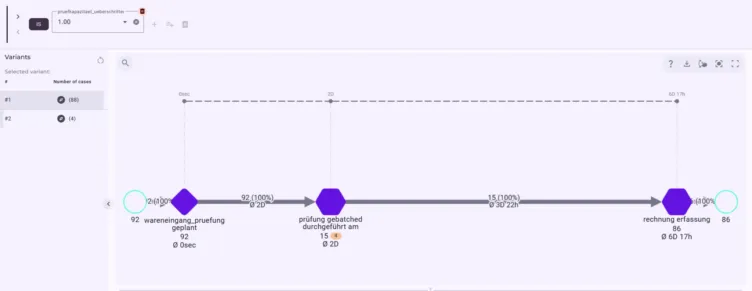
Damit wird aus einem allgemeinen Zeitmuster ein konkretes Finding: Für diese Geschäftsobjekte hat die vorgesehene Prüfkapazität zum relevanten Zeitpunkt nicht ausgereicht. Interessant wird es, wenn die Analyse anschließend bis zur Zahlung weitergeführt wird. Noreja kann dieselbe betroffene Objektpopulation entlang der Beziehungen zu Rechnung und Zahlung verfolgen und damit operative Engpässe von wirtschaftlichen Wirkungstreibern unterscheiden.
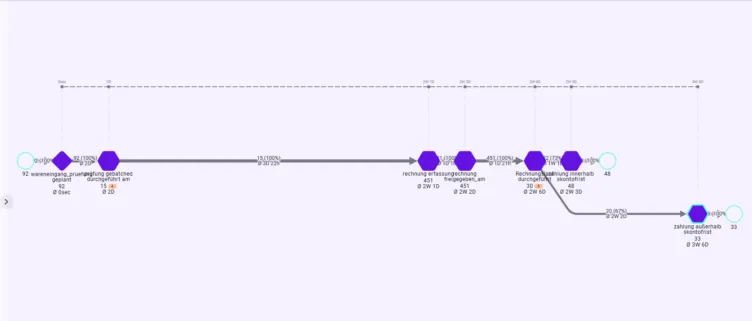
Genau darin liegt der Mehrwert einer kausalen Betrachtung. Ein operativer Engpass kann real sein, ohne automatisch der dominante Treiber jedes später sichtbaren finanziellen Effekts zu sein. Statt aus zwei gleichzeitig sichtbaren Auffälligkeiten vorschnell eine Ursache-Wirkungs-Beziehung abzuleiten, wird geprüft, ob dieselben betroffenen Geschäftsobjekte tatsächlich entlang des Prozesses zusammenhängen. Der wirtschaftliche Effekt selbst lässt sich ebenfalls sichtbar machen. Im synthetischen Datensatz liegen 2.209 Zahlungen außerhalb der Skontofrist. Der daraus modellierte Skontoverlust wird bis auf Euro-Ebene quantifiziert. Damit wird aus einer allgemeinen Frage nach „zu langen Durchlaufzeiten“ eine wesentlich präzisere Steuerungsfrage: Welche Prozessbedingungen erzeugen tatsächlich einen vermeidbaren wirtschaftlichen Effekt – und welche sind lediglich gleichzeitig sichtbar?
Maverick Buying: Wenn der schnelle Pfad fachlich falsch ist
Nicht jedes Prozessproblem äußert sich als Verzögerung. Im Einkauf kann sogar das Gegenteil gelten: Ein Vorgang ist schneller als vorgesehen, weil notwendige Kontrollen übersprungen werden.
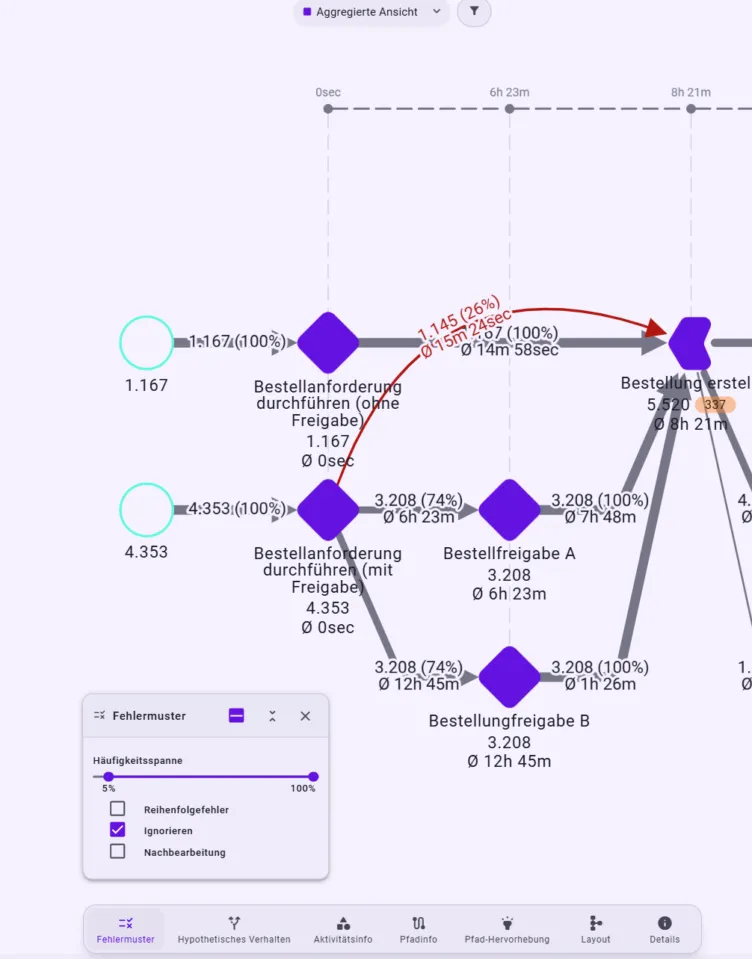
Im aktuellen Demo-Run führen 1.145 freigabepflichtige Bestellanforderungen direkt zur Bestellung, ohne die vorgesehenen Freigabeschritte vollständig zu durchlaufen. Das entspricht rund 26,3 Prozent der betrachteten freigabepflichtigen Anforderungen. Eine reine Performance-Betrachtung könnte diesen Pfad positiv bewerten: weniger Schritte, kürzere Zeit bis zur Bestellung. Fachlich ist genau das Gegenteil relevant. Der Prozess ist schnell, weil eine vorgesehene Kontrolle nicht stattfindet.
Der schnellste Prozesspfad ist nicht automatisch der beste Prozesspfad.
Der Drill-down auf die Eigenschaften der betroffenen Fälle zeigt anschließend eine deutliche Konzentration auf bestimmte Anforderer. 597 Fälle entfallen auf Kaya, 515 auf Braun. Zusammen sind das rund 97 Prozent der betroffenen Vorgänge.
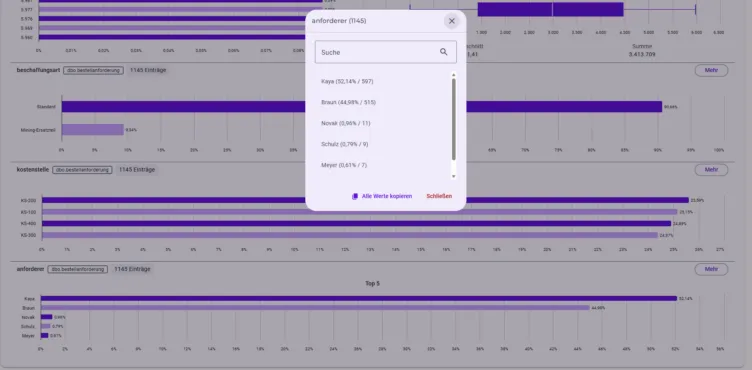
Damit wird aus „1.145 Freigabeverstößen“ eine abgrenzbare Ursachenhypothese. Der Prozessverantwortliche kann nun gezielt untersuchen, warum sich das Verhalten auf diese Gruppe konzentriert – etwa Berechtigungen, organisatorische Sonderregeln, Zeitdruck oder fehlende Akzeptanz. Causal Process Mining liefert an dieser Stelle nicht einfach eine weitere Variante, sondern verbindet das Fehlermuster mit den Merkmalen der betroffenen Geschäftsobjekte.
Rechnungsnacharbeit: Erst Kontext macht das Finding verständlich
Ein weiteres Beispiel zeigt die Rechnungsbearbeitung. Der Analyzer erkennt zwei deutliche Nachbearbeitungsschleifen mit 554 und 93 Fällen. Zusammen sind damit 647 Fälle von wiederholter Bearbeitung betroffen. Damit wissen wir, dass Nacharbeit stattfindet. Für die Prozessverbesserung fehlt jedoch noch die entscheidende Information: Warum müssen diese Rechnungen erneut bearbeitet oder manuell geklärt werden? Genau hier erweitert Noreja die Analyse um zusätzlichen fachlichen Kontext. In der Demo wurden Informationen aus einem IT-/Support-Ticketsystem in Noreja Context eingebunden. Über die Rechnungs-ID kann Minerva die betroffenen Prozessinstanzen mit den dort dokumentierten Klärungsgründen verbinden.
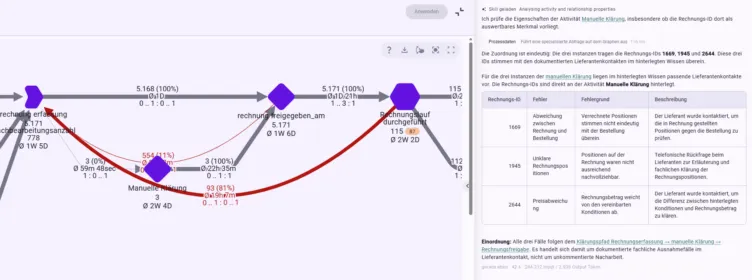
Für die gezeigten Fälle werden beispielsweise Abweichungen zwischen Rechnung und Bestellung, unklare Rechnungspositionen oder Preisabweichungen zu vereinbarten Konditionen sichtbar. Damit verändert sich die Aussage von:
„Rechnungen werden nachbearbeitet.“
zu:
„Diese fachlichen Gründe lösen die Nacharbeit aus.“
Das ist ein wichtiger Unterschied. Die Ursache eines Prozessproblems muss nicht vollständig in den operativen Prozessdaten selbst enthalten sein. Tickets, Kommentare, Qualitätsmeldungen oder andere fachliche Informationen können den Kontext liefern, der aus einem Fehlermuster eine handlungsfähige Diagnose macht. Aus den unterschiedlichen Ursachen folgen wiederum unterschiedliche Verbesserungshypothesen: Validierungen zwischen Bestellung und Rechnung früher greifen lassen, Rechnungspositionen standardisieren oder Konditionsdaten früher prüfen.
Lieferantenperformance: Derselbe Prozess, deutlich andere Laufzeit
Nicht jede Ursache liegt im eigenen Unternehmen. Die Lieferantenanalyse zeigt, wie derselbe Standardprozess bei bestimmten externen Partnern deutlich länger dauern kann.
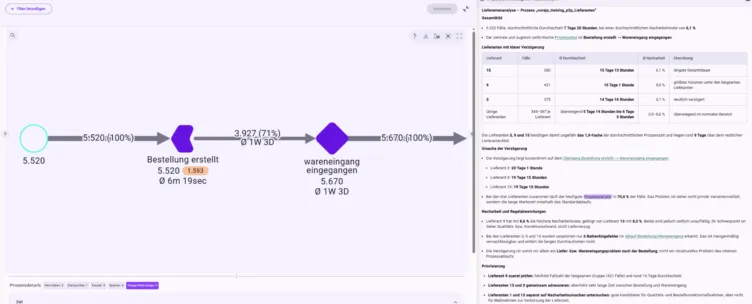
Im synthetischen Datensatz benötigen drei Lieferanten durchschnittlich rund 14 bis 15,5 Tage, während die übrigen Lieferanten überwiegend bei etwa 5,5 bis gut 6 Tagen liegen. Die zusätzliche Zeit konzentriert sich insbesondere auf den Abschnitt zwischen Bestellung erstellt und Wareneingang eingegangen. Gleichzeitig folgen die betroffenen Lieferanten überwiegend dem normalen Prozesspfad. Eine hohe Variantenvielfalt oder außergewöhnlich viel Nacharbeit erklärt die Verzögerung nicht. Damit verschiebt sich die Frage von:
„Warum ist unser Purchase-to-Pay-Prozess langsam?“
zu:
„Warum benötigt derselbe Standardprozess bei bestimmten Lieferanten deutlich länger?“
Das ist für die Maßnahme entscheidend. Ein interner Workflow-Umbau würde eine externe Lieferverzögerung kaum beheben. Stattdessen rücken Lieferzeiten, Disposition, Vereinbarungen und die Zusammenarbeit mit den betroffenen Lieferanten in den Fokus.
Minerva verbindet die Findings zu einem Gesamtbild
Je mehr Findings entstehen, desto wichtiger wird ihre fachliche Einordnung. Minerva kann die unterschiedlichen Analyseergebnisse übergreifend zusammenführen und dabei zwischen Compliance-Abweichungen, Nacharbeit, Zeitmustern, Lieferantenperformance und weiteren Prozessproblemen unterscheiden.
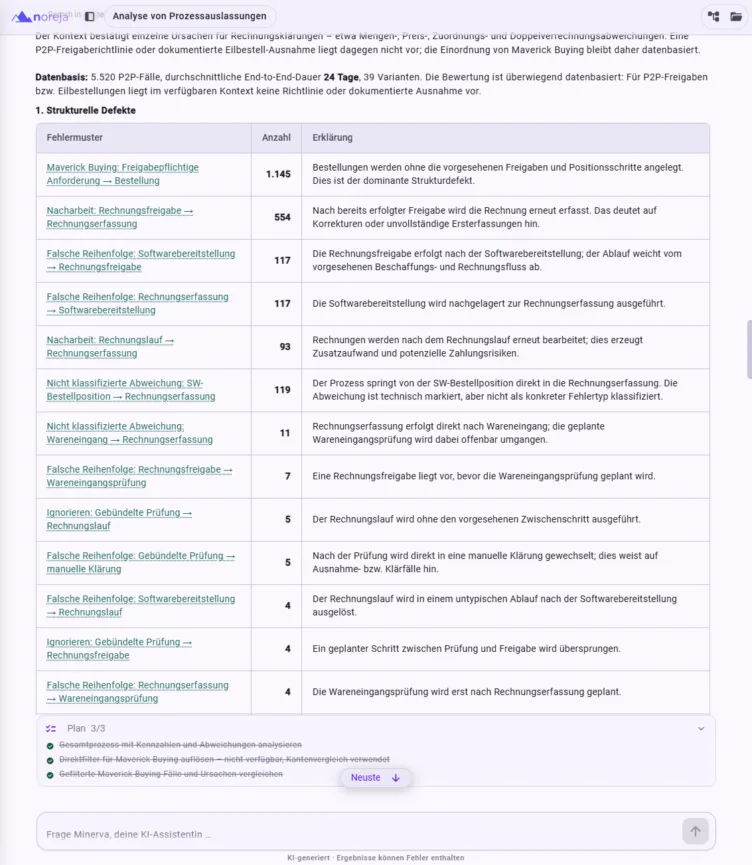
Die Analyse zeigt damit nicht „die eine Root Cause“ für den gesamten P2P-Prozess. Stattdessen werden unterschiedliche Wirkmechanismen getrennt: Beim Maverick Buying geht es um die Umgehung vorgesehener Freigaben. Bei der Rechnungsbearbeitung um wiederkehrende fachliche Klärungsgründe. Bei der Wareneingangsprüfung um gemeinsam genutzte Ressourcen und Batchlogik. Bei der Lieferantenperformance um externe Durchlaufzeittreiber.
Der Anwender muss dafür nicht mit der Bedienlogik einer Analyseoberfläche beginnen. Er kann mit einer fachlichen Frage starten, während Minerva relevante Perspektiven, Findings und Kontextinformationen zusammenführt.
Die Business-Frage steht am Anfang – nicht die Wahl von View, Filter und Visualisierung.
Vom Finding zur priorisierten Verbesserung
Ein Finding allein verbessert noch keinen Prozess. Der entscheidende Schritt beginnt danach: Prozessverantwortliche müssen bewerten, welche Erkenntnisse wirtschaftlich relevant, organisatorisch umsetzbar und mit vertretbarer Unsicherheit verbunden sind. Die identifizierten Findings können deshalb anschließend in das Business Impact Board übernommen und dort beispielsweise nach Wirkung, Umsetzungsaufwand und Unsicherheit bewertet und priorisiert werden. Aus einer Auffälligkeit wird so eine konkrete Verbesserungsinitiative mit einer nachvollziehbaren Entscheidung, warum sie zuerst – oder bewusst später – umgesetzt wird. KI kann dabei Analysewege und Handlungsoptionen vorbereiten. Die Entscheidung über die Maßnahme bleibt beim Prozessverantwortlichen und Fachbereich. Nach der Umsetzung schließt sich der Regelkreis: Dieselben granularen Daten und dieselbe Prozesslogik können erneut genutzt werden, um zu prüfen, ob Freigabeumgehungen, Nacharbeit, Lieferzeiten oder finanzielle Effekte tatsächlich zurückgegangen sind.
Insight → Action → Impact → Feedback
Was bedeutet das für Prozessmanager?
Der Purchase-to-Pay-Prozess zeigt, warum Prozesssteuerung mehr benötigt als eine Prozesskarte und Durchschnittszeiten. Ein Vorgang kann langsam sein, weil viele Fälle dieselbe Ressource teilen. Ein Vorgang kann sehr schnell sein, weil eine notwendige Freigabe übersprungen wird. Rechnungsnacharbeit kann erst durch zusätzlichen Kontext verständlich werden. Und eine vermeintlich interne Verzögerung kann sich auf wenige Lieferanten konzentrieren. Für modernes Prozessmanagement ergeben sich daraus vier Konsequenzen:
- Daten granular übernehmen: Geschäftsobjekte, Attribute, Ereignisse und Beziehungen bleiben erhalten und müssen nicht vorab auf eine einzige Prozesssicht reduziert werden.
- Ursachen statt nur Auffälligkeiten untersuchen: Causal Process Mining prüft fachliche Ursache-Wirkungs-Hypothesen entlang derselben betroffenen Geschäftsobjekte.
- Kontext einbeziehen: Relevante Erklärungen liegen häufig außerhalb der operativen Transaktionsdaten und müssen mit dem Prozesswissen verbunden werden.
- Findings priorisieren und Wirkung messen: Prozessverantwortliche bewerten Erkenntnisse nach Wirkung, Aufwand und Unsicherheit, setzen geeignete Maßnahmen um und messen anschließend erneut.
Die zentrale Frage lautet damit nicht mehr nur:
„Was ist in unserem Purchase-to-Pay-Prozess passiert?“
Sondern:
„Warum ist es passiert, wo liegt der veränderbare Hebel – und hat unsere Maßnahme anschließend tatsächlich gewirkt?“

